Wie wird die Sicherheit von KI-Modellen gewährleistet?
Das Thema dieses Abschnitts ist Datenetikettierung boom.
„Die Daten sind das neue Gold, aber nur, wenn sie präzise geschliffen sind.“
Der steigende Bedarf an hochwertigen Trainingsdaten treibt die Entwicklung spezialisierter Dienstleistungen im Bereich der Datenetikettierung voran.
Dieser Prozess ist essenziell, um KI-Modelle mit präzisen Informationen zu füttern, was die Grundlage für technologische Fortschritte in verschiedensten Industrien bildet.
In diesem Artikel erfahren Sie, wie die Skalierung der Datenbeschriftung funktioniert, welche regulatorischen Rahmenbedingungen die Datenqualität für KI beeinflussen und wie Unternehmen wie Scale AI auf globale Herausforderungen reagieren.
Wie beeinflusst die Skalierung der Datenbeschriftung die KI-Modellentwicklung?
Ein Techniker sitzt vor einem Monitor und zieht präzise Rahmen um Objekte in einem Satellitenbild, um die Maschine auf die Erkennung von Veränderungen zu trainieren. Ein solcher Prozess ist der Kern der Datenbeschriftung, die sicherstellt, dass Algorithmen die Welt korrekt interpretieren.
Die Skalierung der Datenbeschriftung ist entscheidend, da die Genauigkeit der Trainingsdaten direkt die Leistungsfähigkeit der KI-Modelle bestimmt. Wenn die Menge und Qualität der annotierten Daten steigen, können Modelle komplexere Muster erkennen und zuverlässiger agieren.
Dies ist besonders wichtig in Bereichen, in denen kleinste Fehler große Auswirkungen haben könnten.
In der Praxis bedeutet dies, dass Unternehmen massiv in Werkzeuge und Prozesse investieren, um riesige Datenmengen effizient zu verarbeiten. Ohne eine strukturierte Aufbereitung der Rohdaten blieben die fortschrittlichsten Algorithmen weitgehend wirkungslos.
Die Entwicklung von spezialisierten Dienstleistungen ermöglicht es, diese enormen Datenmengen systematisch zu bewältigen.
In diesem Zusammenhang ist der zweite Punkt der wichtigste.
Welche Rolle spielen regulatorische Vorgaben für die Datenqualität für KI?
Im kühlen Büro wird die Tinte auf dem Papier spürbar, während die Uhr an der Wand laut tickt.
Ein Anwalt prüft ein Dokument über Datenschutzrechte, während im Hintergrund ein Serverraum leise summt. Die Einhaltung von Gesetzen wie der DSGVO ist kein Hindernis, sondern ein Qualitätsmerkament für die Verarbeitung sensibler Informationen.
Die Datenqualität für KI wird zunehmend durch rechtliche Rahmenbedingungen definiert, die den Schutz der Privatsphäre sicherstellen. Gesetzgeber weltweit orientieren sich dabei oft an strengen Standards, um den Missbrauch von Nutzerdaten zu verhindern.
Dies zwingt Unternehmen dazu, Prozesse zu entwickeln, die sowohl präzise als auch ethisch vertretbar sind.
Laut Wikipedia wurden Richtlinien wie der California Privacy Rights Act (CPRA, 2020) in Kalifornien und PIPEDA in Kanada geschaffen, die sich an der Datenschutz-Grundverordnung (DSGVO) der Europäischen Union orientieren, um Verbraucherdaten und das Recht auf Privatsphäre an erste Stelle zu setzen.
Solche Regelungen stellen sicher, dass die für das Training genutzten Daten rechtmäßig und unter Wahrung der Anonymität erhoben werden.
Ein weiteres Beispiel für die Bedeutung von Regeln ist die Durchsetzung von Datenschutzstandards durch staatliche Behörden.
Im September 2019 verhängte die schwedische Datenschutzbehörde (DPA) die erste Geldstrafe wegen eines Verstoßes gegen die DSGVO gegen eine Schule, die die Technologie zum Ersatz zeitaufwendiger Anwesenheitskonten im Unterricht einsetzte.
Solche Fälle zeigen, dass die Verwendung von Daten strengen Regeln unterliegt.
In diesem Zusammenhang ist der zweite Punkt der wichtigste.
Wie reagieren Unternehmen auf die steigenden Datenanforderungen AI?
Ein Ingenieur passt die Parameter eines Modells an, nachdem eine neue Datenreihe eingereicht wurde. Die Anpassung an neue, unvorhergesehene Anforderungen ist ein ständiger Teil des industriellen KI-Lebenszyklus.
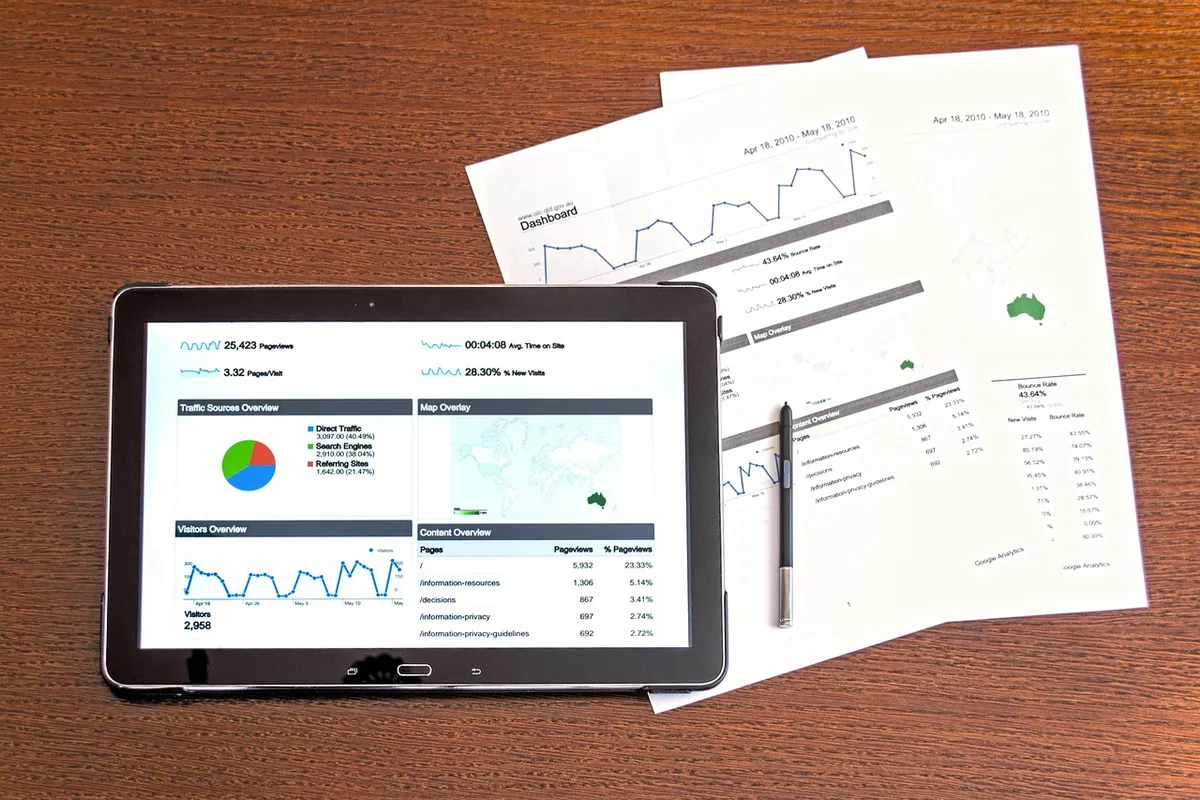
Die Datenanforderungen AI verändern sich ständig, je nachdem, in welchen neuen Einsatzgebieten die Technologie landet. Unternehmen müssen ihre Infrastruktur flexibel halten, um auf neue Aufgabenstellungen reagieren zu können.
Dies erfordert nicht nur technische Kapazitäten, sondern auch die Fähigkeit, spezialisierte Dienstleistungen für spezifische Anwendungsfälle zu entwickeln.
Im Februar 2022 entwickelte Scale AI als Reaktion auf die russische Invasion in der Ukraine den Automated Damage Identification Service. Dies zeigt, wie spezialisierte Datenverarbeitung auf globale Krisen und neue Anforderungen reagieren kann.
Die Branche entwickelt sich weg von allgemeinen Lösungen hin zu hochspezialisierten Werkzeugen für spezifische Probleme.
Ein wichtiger Aspekt ist die Zusammenarbeit zwischen Industrie und staatlichen Institutionen, um Sicherheitsstandards zu etablieren.
Im August 2024 unterzeichnete Scale eine Vereinbarung mit dem US AI Safety Institute, um bei der Forschung, dem Testen und der Bewertung der unternehmenseigenen KI-Modelle zu kooperieren. Solche Partnerschaften helfen dabei, die Zuverlässigkeit der Modelle zu gewährleisten.
In diesem Zusammenhang ist der zweite Punkt der wichtigste.
Wie lässt sich eine effiziente Datenverarbeitung in drei Schritten umsetzen?
Ein Projektleiter erstellt einen Zeitplan für die Annotation von tausenden Bildern. Die Strukturierung des Workflows ist der Schlüssel zur Bewältigung massiver Datenmengen.
Um eine zuverlässige Datenverarbeitung aufzubauen, können folgende Schritte befolgt werden:
- Definition der Annotationsrichtlinien: Zuerst müssen klare, unmissverständliche Anweisungen für die Kennzeichnung der Daten erstellt werden, um Konsistenz zu gewährleisten. 2. Implementierung von Validierungsprozessen: Es müssen Mechanismen eingeführt werden, die die Korrektheit der Etiketten durch Stichproben oder Kreuzvalidierung prüfen. 3. Skalierung durch Automatisierung: Sobald die manuellen Prozesse stabil sind, können Werkzeuge zur Automatisierung eingesetzt werden, um die Effizienz zu steigern.
Nach Abschluss dieser Schritte muss eine abschließende Prüfung der Datenintegrität erfolgen, um sicherzustellen, dass die gelabelten Datensätze den Anforderungen des Zielmodells entsprechen.
Ich habe in der Vergangenheit gesehen, wie wichtig die erste Phase der Richtliniendefinition für den gesamten Erfolg eines Projekts war.
| Aspekt | Fokus | Ziel |
|---|---|---|
| Manuelle Annotation | Präzision und Detailtiefe | Hohe Genauigkeit für komplexe Aufgaben |
| Automatisierte Verarbeitung | Geschwindigkeit und Volumen | Skalierung für riesige Datensätze |
- Definition der Anforderungen
- Implementierung der Workflows
- Qualitätssicherung
In diesem Zusammenhang ist der zweite Punkt der wichtigste.
Welche Einschränkungen gibt es bei der Skalierung der Datenbeschriftung?
Ein Mitarbeiter betrachtet eine Fehlermeldung auf einem Tablet, die auf eine inkonsistente Datenkennzeichnung hinweist. Selbst die besten Systeme stoßen an Grenzen, wenn die Datenqualität nicht durchgehend kontrolliert wird.
Eine wesentliche Einschränkung ist die Abhängigkeit von der Qualität der Ausgangsdaten. Wenn die Rohdaten fehlerhaft oder verzerrt sind, kann auch die beste Etikettierung keine verlässlichen Ergebnisse liefern.
Zudem können sich spezifische Bedingungen wie die im Jahr 2026Q2 verzeichnete wirtschaftliche Entwicklung mit einer realen Wirtschaftswachstumsrate von 0,6 % auf die Investitionsfähigkeit in teure Datenprojekte auswirken.
Ein weiteres Problem ist die Gefahr des "Bias" oder der Voreingenommenheit in den Daten. Wenn die menschlichen Annotatoren oder die verwendeten Algorithmen einseitig arbeiten, werden diese Fehler in das fertige Modell übertragen.
Dies kann zu diskriminierenden oder ungenauen Entscheidungen der KI führen.
In diesem Zusammenhang ist der zweite Punkt der wichtigste.
Datenetikettierung boom
Das Thema dieses Abschnitts ist Datenetikettierung boom.
Dasselbe Thema heißt auch KI-Trainingsdaten Bedarf.
Dasselbe Thema heißt auch Datenbeschriftung Wachstum.
Dasselbe Thema heißt auch Industrie KI Daten.
Dieser Teil behandelt auch AI-Modelltraining Daten.
Verwandte Artikel
Kommentare 0