Etichettatura dati AI crescita: guida per modelli complessi
"L'intelligenza artificiale non si nutre di algoritmi astratti, ma di dati reali, catalogati e pronti per essere processati."
L'industria dell'etichettatura dati sta vivendo una fase di espansione strategica guidata dalla necessità di alimentare modelli sempre più complessi.
Questo fenomeno risponde a una domanda crescente in settori che spaziano dalla sicurezza globale alla gestione della privacy, rendendo i dati strutturati il pilastro dell'innovazione tecnologica. 1. La crescita della domanda di etichettatura dati è legata alla complessità dei nuovi modelli. 2. Le esigenze di addestramento AI dati variano drasticamente tra contesti civili e militari. 3. La scalabilità AI dati richiede standard rigorosi per garantire la sicurezza e la conformità. * Un limite principale rimane la gestione etica e legale della privacy durante la raccolta.
Come la domanda etichettatura dati influenza lo sviluppo tecnologico?
Mentre il sole tramonta sull'ufficio, il tecnico stringe la penna e si concentra sull'etichettatura per trasformare le immagini in pura conoscenza.
Un tecnico osserva lo schermo mentre seleziona meticolosamente i contorni di un oggetto in un'immagine satellitare per addestrare un sistema di riconoscimento.
La precisione di questo compito manuale o semi-automatico è ciò che permette a un software di distinguere un dettaglio vitale da un semplice rumore visivo.
La domanda etichettatura dati è il motore che trasforma i dati grezzi in conoscenza utilizzabile. Senza un processo di categorizzazione accurato, i modelli di apprendimento automatico non potrebbero interpretare correttamente il mondo fisico.
Questo bisogno si manifesta in ogni settore che richiede automazione decisionale, rendendo l'accuratezza del dato il fattore determinante per il successo di qualsiasi progetto digitale.
Secondo Wikipedia, nel febbraio 2022, Scale AI ha sviluppato il suo Automated Damage Identification Service in risposta all'invasione russa dell'Ucraina. Questo esempio dimostra come le necessità geopolitiche possano generare nuovi mercati per l'elaborazione delle informazioni.
Il passaggio da dati generici a dati specifici per scenari critici è una tendenza in crescita.
Quali sono i fattori che alimentano l'addestramento AI dati?
Un ricercatore analizza una serie di dataset complessi, cercando di capire come piccoli errori di etichettatura possano influenzare l'output finale di un modello. Il lavoro costante di raffinamento è la base per la stabilità dei sistemi avanzati.
L'addestramento AI dati richiede una quantità massiccia di esempi etichettati per garantire che i modelli siano robusti. La varietà dei dati deve coprire ogni possibile scenario operativo, dai compiti quotidiani alle situazioni di emergenza.
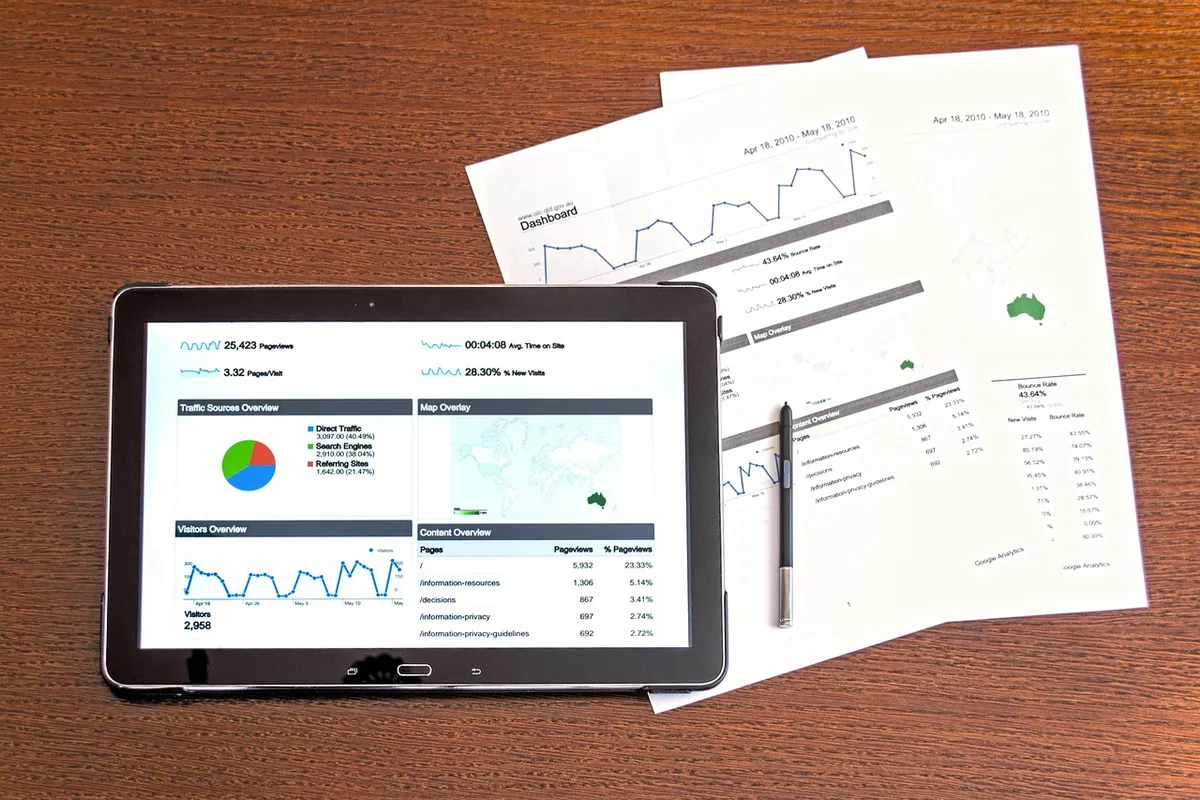
La capacità di fornire dataset diversificati è diventata un vantaggio competitivo per le aziende che operano nel settore.
Questa dinamica è visibile nei grandi investimenti che mirano a consolidare le infrastrutture di dati. Ad esempio, nel giugno 2025, è stato riportato che Meta Platforms aveva concordato l'acquisto di una quota del 49% (senza diritto di voto) in Scale AI per 14,8 miliardi di dollari.
Un investimento di questa portata sottolinea l'importanza strategica della gestione dei dati.
Come si gestisce la scalabilità AI dati in mercati globali?
Un manager di progetto coordina un team distribuito in diversi fusi orari, assicurandosi che le linee guida per l'etichettatura siano applicate uniformemente. La gestione della scala è una sfida logistica costante.
Come riportato dall'AI Safety Institut, nell'agosto 2024 Scale ha firmato un accordo con l'US AI Safety Institute per collaborare alla ricerca, al testing e alla valutazione dei modelli di IA dell'azienda.
La scalabilità AI dati dipende dalla capacità di gestire volumi crescenti di informazioni senza perdere la qualità. Per mantenere la precisione, le aziende devono implementare processi di controllo qualità rigorosi e sistemi di gestione automatizzati.
La scalabilità non riguarda solo la quantità, ma anche la capacità di mantenere standard elevati su scala globale.
La gestione di grandi volumi richiede anche una collaborazione tra industria e istituzioni. Nel mese di agosto 2024, Scale ha firmato un accordo con l'US AI Safety Institute per collaborare alla ricerca, ai test e alla valutazione dei modelli AI dell'azienda.
Questo tipo di partnership è essenziale per integrare la crescita con la sicurezza.
Quali sono i rischi legati ai servizi etichettatura dati e alla privacy?
Un legale esamina attentamente i termini di servizio e le normative sulla protezione dei dati, cercando di prevenire violazioni che potrebbero compromettere l'intero progetto. La conformità è un elemento inscindibile dal lavoro sui dati.
Secondo la Swedish Data Protection Authority, nel settembre 2019 l'autorità ha inflitto la sua prima sanzione finanziaria per una violazione del GDPR contro una scuola che utilizzava tale tecnologia per sostituire i registri di classe.
L'integrazione di servizi etichettatura dati deve confrontarsi con normative sempre più stringenti sulla privacy. La raccolta e la manipolazione di dati personali richiedono un'attenzione estrema per evitare sanzioni e danni reputazionali.
Il bilanciamento tra la necessità di dati e il diritto alla riservatezza è la sfida principale del settore.
Le normative riflettono questa tensione.
Ad esempio, la California ha creato il California Privacy Rights Act (CPRA, 2020) e il Canada ha creato il PIPEDA (Government of Canada, 2021), entrambi modellati sulle linee guida dell'Unione Europea che mette al primo posto i diritti di privacy dei consumatori e degli utenti.
Queste leggi influenzano direttamente il modo in cui i dati vengono trattati.
Come si applicano le normative alla gestione dei dataset?
Un supervisore verifica che ogni immagine utilizzata per il training sia stata acquisita nel rispetto delle leggi vigenti. La conformità legale è un processo continuo di verifica e controllo.
Per operare correttamente, le aziende devono seguire una procedura strutturata:
- Analisi della provenienza dei dati per garantire la legalità del dataset. 2. Implementazione di tecniche di anonimizzazione per proteggere l'identità degli utenti. 3. Verifica finale della conformità rispetto alle normative locali e internazionali.
Un controllo costante è necessario per prevenire incidenti legali. Nel settembre 2019, l'Autorità svedese per la protezione dei dati (DPA) ha emesso la sua prima sanzione finanziaria per una violazione del GDPR contro una scuola che utilizzava la tecnologia per sostituire i registri di classe.
Questo evento sottolinea i rischi legati all'uso improprio di tecnologie di riconoscimento.
L'integrazione di questi processi garantisce che l'innovazione non avvenga a scapito dei diritti fondamentali. Osservando la storia delle sanzioni, è chiaro che le regole sulla privacy influenzano l'adozione tecnologica.
| Fattore di Rischio | Impatto sul Settore |
|---|---|
| Violazione della Privacy | Sanzioni legali e perdita di fiducia |
| Dati non conformi | Necessità di ri-addestramento dei modelli |
L'applicazione di queste regole è fondamentale per mantenere la sostenibilità del mercato.
Etichettatura dati AI crescita
Il tema di questa sezione è Etichettatura dati AI crescita.
Lo stesso tema si dice anche Mercato dati industriale.
Questa parte copre anche Bisogno dati avanzati.
Articoli correlati
Commenti 0