Crescimento do dado para IA: desafios e marcos regulatórios
"O desenvolvimento de modelos de inteligência artificial depende diretamente da qualidade dos dados que os alimentam, transformando a rotulagem em um pilar estratégico."
A demanda de rotulagem de dados cresce à medida que modelos de IA exigem conjuntos de informações cada vez mais precisos e contextuais. Este processo é essencial para garantir a eficácia tecnológica e a segurança dos sistemas em diversos setores.
Este artigo explora a relação entre o crescimento do dado para IA e a expansão do treinamento IA, abordando as necessidades de mercado, os desafios de segurança e os marcos regulatórios.
Como a demanda de rotulagem de dados impulsiona novas tecnologias?
Ao entardecer, o técnico aperta os olhos enquanto observa o crescimento de padrões complexos na tela brilhante do laboratório.
Um técnico ajusta as coordenadas de uma imagem em uma tela de alta resolução para treinar um algoritmo de detecção. O trabalho minucioso de identificar objetos é o que permite que máquinas reconheçam padrões no mundo real.
A demanda de rotulagem de dados surge da necessidade de transformar informações brutas em conhecimento estruturado para máquinas. Sem esse processo, os modelos de linguagem e visão computacional não conseguiriam interpretar nuances complexas.
A expansão do treinamento IA depende da escala e da precisão dessas marcações para evitar erros de interpretação.
Segundo a Wikipedia, em fevereiro de 2022, a Scale AI desenvolveu seu Serviço de Identificação Automatizada de Danos em resposta à invasão russa na Ucrânia. Este movimento demonstra como necessidades geopolíticas imediatas podem gerar demandas específicas por dados rotulados.
A capacidade de processar imagens de danos em larga escala tornou-se uma ferramenta de resposta rápida.
Qual é a relação entre dados e IA no mercado global? Crescimento do dado para IA
No escritório silencioso, o analista sente o frio do ar-condicionado enquanto acompanha o crescimento dos gráficos em seu monitor.
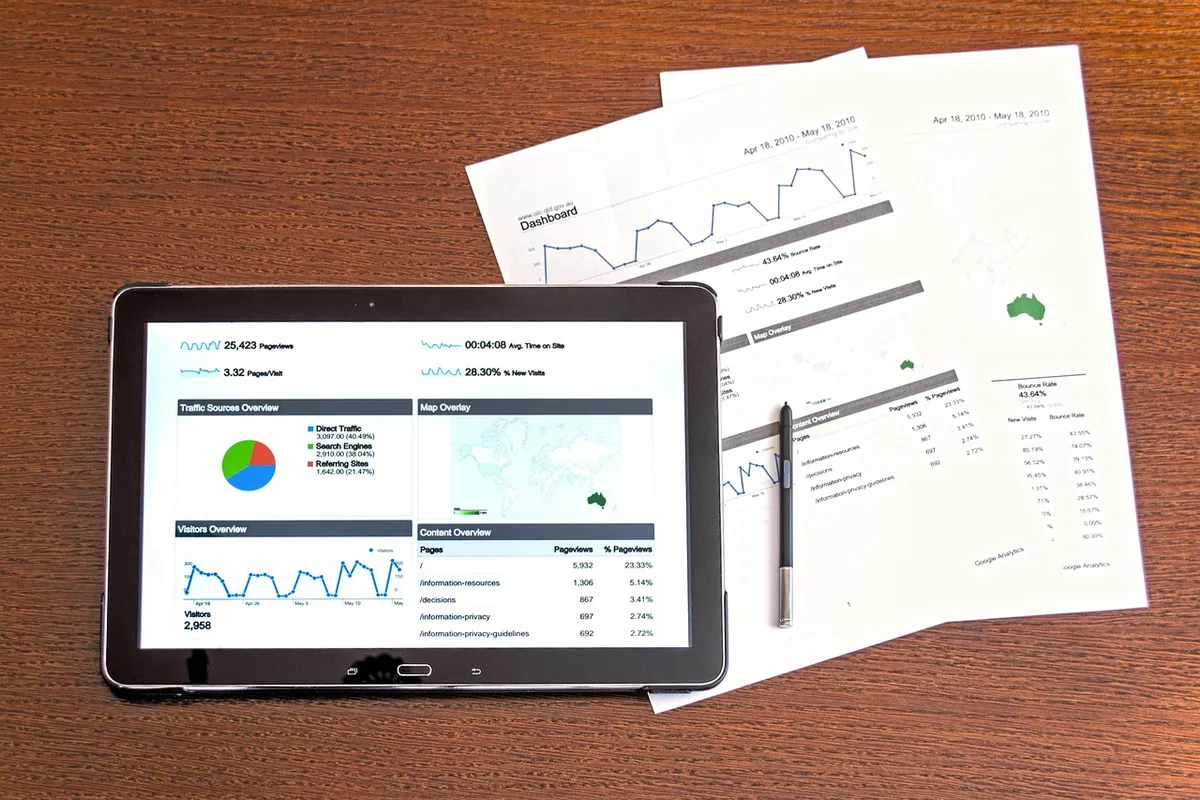
Um analista observa gráficos de crescimento enquanto uma equipe de engenheiros processa terabytes de informações em um servidor. A escala do processamento é o motor que move o setor tecnológico.
A relação entre dados e IA é de dependência absoluta, onde a qualidade do dado define o limite do desempenho do modelo. À medida que as empresas buscam soluções mais inteligentes, o mercado de dados para IA se torna um setor de infraestrutura crítica.
O crescimento do dado para IA não é apenas sobre volume, mas sobre a sofisticação das etiquetas aplicadas.
Em agosto de 2024, a Scale assinou um acordo com o US AI Safety Institute para colaborar na pesquisa, teste e avaliação de seus modelos de IA, segundo a Wikipedia. Esse tipo de parceria reforça que a rotulagem não é apenas uma tarefa técnica, mas um componente de segurança.
O objetivo é garantir que os modelos treinados com esses dados sigam padrões rigorosos de confiabilidade.
Como a expansão do treinamento IA lida com a segurança e ética?
Um especialista em segurança digital revisa protocolos de privacidade enquanto um novo conjunto de dados é carregado no sistema. A proteção de informações é um passo constante no ciclo de desenvolvimento.
A expansão do treinamento IA traz desafios significativos para a privacidade e a ética, exigindo métodos de rotulagem que respeitem os direitos individuais. O setor de dados rotulados precisa equilibrar a necessidade de grandes volumes de informação com as restrições de proteção ao usuário.
A integridade do treinamento depende de como esses dados são coletados e tratados.
Em setembro de 2019, a Autoridade de Proteção de Dados (DPA) da Suécia aplicou a primeira penalidade financeira por violação do GDPR contra uma escola que usava tecnologia para substituir chamadas em sala de aula, conforme relatado pela Wikipedia.
Esse caso ilustra os riscos de usar dados para treinamento ou automação sem conformidade. A governança sobre os dados é essencial para evitar penalidades e proteger a sociedade.
Quais são os marcos regulatórios que moldam o setor de dados?
Um advogado analisa documentos legais ao lado de um desenvolvedor de software em um escritório moderno. A conformidade com as leis é o que permite a operação contínりada de empresas globais.
As leis de privacidade estabelecem as regras do jogo para a coleta e o uso de informações no treinamento de modelos. Diferentes regiões do mundo adotam diretrizes que influenciam como a rotulagem de dados é executada globalmente.
O setor deve se adaptar constantemente às mudanças legislativas para manter a validade de seus modelos.
Segundo a Wikipedia, a Califórnia criou o California Privacy Rights Act (CPRA, 2020) e o Canadá criou o PIPEDA (Government of Canada, 2021), ambos baseados no GDPR da União Europeia para priorizar os direitos de privacidade do consumidor.
Essas regulamentações moldam como as empresas gerenciam o fluxo de informações. A conformidade regulatória é um elemento central na estratégia de qualquer organização de tecnologia.
Como ocorre a estruturação de um processo de rotulagem?
Um operador de sistemas segue um fluxo de trabalho dividido em etapas claras para garantir a consistência. A padronização evita que o erro humano comprometa a inteligência artificial.
Para garantir a qualidade, o processo de rotulagem deve seguir uma estrutura lógica. Um fluxo de trabalho eficiente geralmente envolve a definição de diretrizes, a execução da marcação e a validação final.
- Definição de critérios: Estabelecer regras claras sobre como cada objeto ou conceito deve ser identificado. 2. Execução da marcação: Aplicar as etiquetas nos conjuntos de dados utilizando ferramentas específicas. 3. Verificação de qualidade: Revisar as marcações para garantir que estão de acordo com os padrões estabelecidos.
Eu acompanhei de perto como a consistência na etapa de verificação de qualidade é o que diferencia um modelo funcional de um erro sistêmico. A precisão é o objetivo final de cada interação com o dado.
- Definição do escopo e diretrizes de classificação.
- Execução da coleta e rotulagem manual ou semiautomática.
- Revisão de qualidade e validação dos conjuntos de dados.
Quais são as limitações do crescimento do setor de dados?
Um gestor analisa o orçamento de investimentos enquanto o mercado apresenta flutuações inesperadas. O planejamento deve considerar as incertezas econômicas e tecnológicas.
Apesar do crescimento, o setor enfrenta limitações relacionadas ao custo de aquisição de dados de alta qualidade e à escassez de mão de obra especializada. Além disso, a conformidade com leis de privacidade pode limitar o acesso a certos tipos de dados sensíveis.
O equilíbrio entre escala e ética é o maior desafio técnico.
A limitação do crescimento pode ocorrer quando as exigências de privacidade tornam o acesso a dados específicos proibitivo, como no caso de regulamentações estritas sobre reconhecimento facial.
Esta parte também cobre Impacto da rotulagem industrial.
Esta parte também cobre Escalabilidade de dados IA.
Artigos relacionados
Comentários 0